O login funcionou, o token é válido, e mesmo assim o cliente leu o extrato de outro.
Todo mundo blinda o
/login, exige senha forte, liga MFA, rotaciona JWT, e deixa oGET /accounts/:id/statementconfiando que quem chegou ali com token válido só vai pedir o próprioid.
O bug número um de API dos últimos anos não é injeção, não é senha fraca, não é token vazado.
É Broken Object Level Authorization - BOLA, o velho IDOR de sempre, primeiro lugar do OWASP API Security Top 10 em 2019 e de novo em 2023.
Essa segunda frase costuma ser lida como estatística de abertura, e ela é, na verdade, o assunto.
Quatro anos separam as duas edições, no meio deles a indústria inteira falou sobre BOLA: virou capítulo em todo curso de segurança de API, laboratório gratuito no PortSwigger, item obrigatório em questionário de fornecedor, argumento de venda de meia dúzia de produtos, nada disso tirou a falha do topo.
Então a pergunta que interessa não é "o que é BOLA", você provavelmente já sabe, é por que uma falha que se descreve em uma frase sobrevive a tanta gente sabendo dela.
Duas respostas, e o resto do artigo é a defesa das duas.
A primeira: BOLA não exige código ruim. Ela nasce da forma mais natural de escrever um endpoint - recebe id, busca objeto, devolve, o caminho seguro exige um passo a mais, amarrar a busca ao dono, e esse passo é fácil de esquecer uma vez em trezentas, não existe o momento em que alguém escreve algo obviamente errado, existe o momento em que alguém escreve o óbvio e o óbvio é inseguro.
A segunda: nenhuma ferramenta encontra isso por você. Scanner nenhum sabe que o extrato 9930 deveria ser invisível para o usuário 42, porque ele não conhece as regras de posse do seu domínio, ele vê dois 200 e não tem como julgar qual dos dois é o errado, não existe assinatura para "este objeto pertence a outra pessoa", existe contexto de negócio, e contexto de negócio é exatamente o que a ferramenta não tem.
Junte as duas: uma falha que depende de o desenvolvedor lembrar, multiplicada pelo número de endpoints, sem detector automático, não é um ranking que se vence com atenção, é um ranking que só se vence mudando a forma de escrever a query, de modo que esquecer resulte em negar.
Enquanto isso, o que se escreve sobre segurança de API segue quase sempre o mesmo roteiro: valide o JWT, não use HS256, use RS256, expire o token em 15 minutos, ligue refresh token rotation, rate limit no login.
Tudo correto, tudo sobre a porta da frente, e o bug que mais vaza dado em API financeira mora do lado de dentro dela, num find(params[:id]) que passou em code review porque parece a coisa mais natural do mundo - e parece porque é.
Eu caço isso em API de serviço financeiro, a parte que assusta não é a raridade, é o oposto: está em quase todo endpoint que recebe um identificador vindo do cliente, e quase nunca aparece como a linha ingênua do exemplo didático.
Vou escrever o artigo que eu queria ter lido quando comecei a testar API: por que autenticar não é autorizar, como fazer o esquecimento falhar fechando em vez de vazando, onde exatamente a checagem some, e como você prova que o buraco existe sem depender de sorte.
Aviso de escopo: isto é engenharia de segurança, não receita de ataque.
Todo teste descrito aqui pressupõe escopo autorizado - contrato de pentest ou política de um programa de divulgação, testar objeto de outra pessoa sem autorização é crime, não pesquisa.
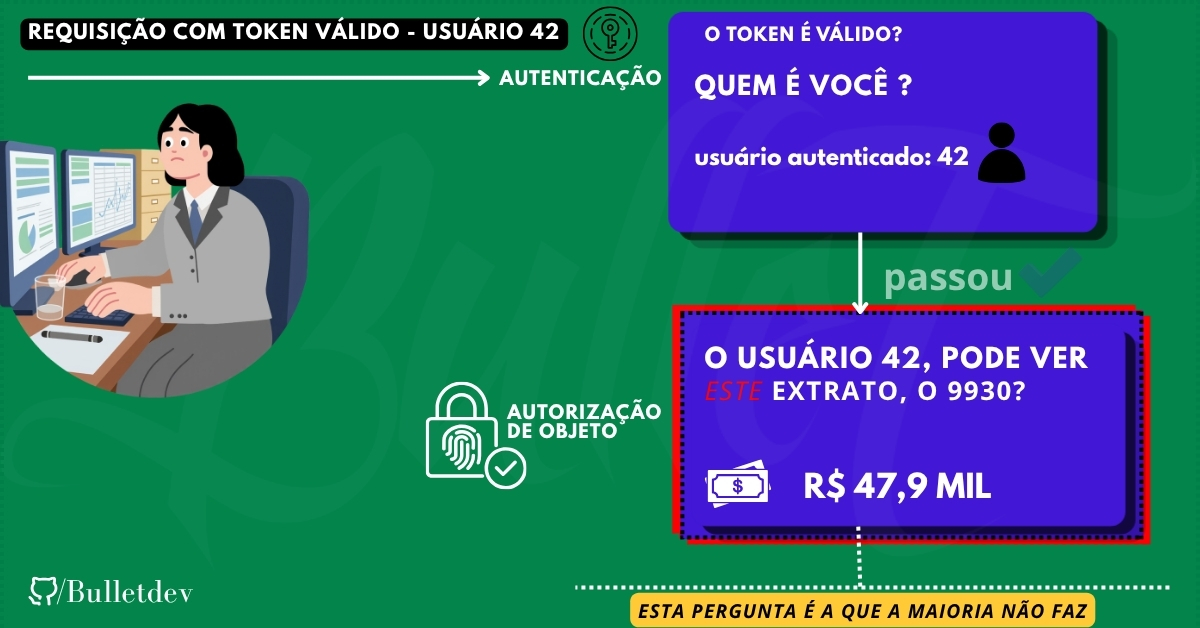
Fig. 1 - A porta da frente é auditada, testada e monitorada, a segunda pergunta costuma não existir no código.
Autenticar responde "quem é você", autorizar responde "você pode isso"
São perguntas diferentes, e o setor inteiro investe na primeira.
Autenticação é a porta da frente: token, senha, MFA, sessão, quando ela funciona, o servidor sabe que a requisição veio do usuário 42.
Ótimo, e aí a maioria dos sistemas para de perguntar.
Autorização em nível de objeto é a segunda pergunta, feita a cada acesso: o usuário 42 pode ver este recurso específico? não "pode ver extratos" - pode ver este extrato, o de número 9931, que pertence à conta 7, que pertence ao usuário 13.
BOLA é o que acontece quando o código responde a primeira pergunta e assume a segunda, o token é válido, então o servidor entrega e ninguém checou de quem é o objeto.
Vale fixar o vocabulário, porque as três falhas vizinhas vivem sendo confundidas e o OWASP separou de propósito:
| Sigla | O que quebra | Exemplo |
|---|---|---|
| BOLA (API1:2023) | acesso a objeto de outro | GET /statements/9930 |
| BOPLA (API3:2023) | acesso a campo que não é seu | PATCH com "role": "admin" |
| BFLA (API5:2023) | acesso a função de outro papel | DELETE /admin/users/9 |
BOLA é movimento horizontal: mesmo papel, objeto alheio, BFLA é vertical: papel maior do que o seu, BOPLA fica no meio, no nível do atributo, os três nascem da mesma raiz, e é essa raiz que interessa.
O login mais robusto do mundo não fecha esse buraco, porque o buraco fica depois da porta.
O problema real nº 1: o id na URL que ninguém confere
Começo pelo caso de livro, e não por ser novidade, começo porque ele é a forma canônica, e todo disfarce da seção 3 é uma deformação dele, se você já conhece esta parte, o que importa é o fim da seção, sobre a direção em que o erro humano falha.
O caso de livro é uma linha que parece inofensiva:
# app/controllers/statements_controller.rb
class StatementsController < ApplicationController
  before_action :authenticate_user!

  def show
    statement = Statement.find(params[:id])
    render json: statement
  end
end
O usuário está autenticado, o before_action rodou, o token é válido, tudo verde e o controller busca o extrato pelo id da URL, sem amarrar ao usuário logado.
Requisição legítima:
GET /statements/9931 HTTP/1.1
Authorization: Bearer <token do usuário 42>
O ataque é trocar um número:
GET /statements/9930 HTTP/1.1
Authorization: Bearer <token do usuário 42>
Mesmo token, mesmo usuário autenticado, extrato de outra pessoa na resposta.
O servidor nunca perguntou de quem é o 9930, isso é BOLA na forma mais pura, e num sistema financeiro o objeto vazado é saldo, CPF, histórico de transação, chave Pix, endereço residencial.
A correção não é validar o token com mais força, é escopar a query pela identidade:
def show
  statement = current_user.statements.find(params[:id])
  render json: statement
end
A diferença é toda a segurança do endpoint, current_user.statements.find(9930) levanta ActiveRecord::RecordNotFound porque o extrato 9930 não está na coleção do usuário 42, e o Rails traduz isso em 404.
A autorização deixou de ser uma checagem que alguém precisa lembrar de escrever e virou a própria forma de buscar o dado.
Repare no que mudou de natureza, a versão insegura precisa que alguém acrescente uma linha de verificação e a versão segura precisa que alguém remova o escopo para quebrar.
Você inverteu o sinal do erro humano: esquecer agora resulta em negar, não em vazar.
Essa inversão é o ponto arquitetural do artigo inteiro e toda vez que uma proteção depende de o desenvolvedor lembrar, ela vai falhar em algum dos 300 endpoints, toda vez que ela é a única forma disponível de escrever a query, ela falha quando alguém sai do caminho de propósito - e sair do caminho de propósito aparece no diff.
A regra: nunca busque por id cru vindo do cliente, busque sempre a partir do dono.
O problema real nº 2: trocar 2 por 3 é fácil demais, então o setor esconde o número
A reação mais comum quando o time descobre BOLA é errada de um jeito específico: trocar o id sequencial por UUID.
GET /statements/9930
GET /statements/e2b1c4a0-7f3d-4a11-9c2e-8f6b0d1a5e77
O raciocínio é que ninguém adivinha um UUID, então ninguém itera e é verdade que dificulta a enumeração cega - de 2^128 possibilidades, força bruta está fora da mesa, mas UUID é ofuscação, não autorização e o objeto continua acessível para qualquer um que tenha o identificador, e identificador vaza o tempo todo:
- No corpo de outra resposta da própria API, quase sempre em uma listagem que devolve mais campo do que a tela usa.
- No cabeçalho
Referer, quando a página com o id na URL carrega qualquer recurso de terceiro. - Em log de aplicação, log de balanceador, APM, histórico de proxy corporativo, Sentry.
- Numa notificação por e-mail, num webhook para o parceiro, numa URL compartilhada por WhatsApp.
- No app mobile de um funcionário, num print colado em ticket de suporte, num CSV de exportação.
O dia em que aquele UUID aparece em qualquer um desses lugares, o endpoint volta a vazar, porque a checagem de dono nunca existiu, você só tornou o bug mais difícil de encontrar - inclusive para quem defende.
E tem um detalhe que quase sempre passa: nem todo UUID é imprevisível, UUID v1 carrega timestamp e endereço MAC, UUID v7, que virou moda por ser ordenável no índice do Postgres, carrega os milissegundos de criação nos primeiros 48 bits 1 se o seu objeto é criado em resposta a uma ação que o atacante dispara, ele conhece o timestamp com precisão de milissegundos e o espaço de busca despenca.
Ordenável no índice e imprevisível para o adversário são requisitos que se contradizem, e a maioria dos times só percebeu o primeiro.
E existe uma variante desse mesmo erro que o framework encoraja ativamente: o identificador assinado. signed_id no Rails, GlobalID, a URL de blob do Active Storage, o link de "compartilhar" que gera um token, aqui o argumento parece mais forte que o do UUID, e é: não é um valor que se adivinha, é um valor com HMAC, imprevisível de verdade.
Imprevisível e mesmo assim não é autorização, um identificador assinado é uma URL de capacidade: quem tem o valor tem o acesso, e a pergunta "quem está do outro lado" nunca é feita, ele não distingue o dono do intruso que recebeu o link, então toda a lista de vazamento acima vale igual - com um agravante próprio, porque esses tokens costumam ter validade longa ou nenhuma, e revogar um deles na prática significa rotacionar a chave e invalidar todos de uma vez.
Capability URL é uma ferramenta legítima para o caso em que a capacidade é o modelo: convite, comprovante público, download temporário com expiração curta, ela vira bug no dia em que alguém a usa como atalho para não escrever a checagem de dono num recurso que tem dono.
UUID e token assinado são boas ideias por outros motivos, como controle de acesso, valem zero.
O problema real nº 3: os disfarces que passam por code review
BOLA sobrevive a revisão porque quase nunca aparece como a linha ingênua do exemplo, aparece disfarçada, e cada disfarce tem um motivo diferente para enganar o revisor.
No corpo, não na URL. O id migra para dentro do JSON e o revisor relaxa, porque "body é dado de negócio":
POST /transfers
Content-Type: application/json

{ "from_account": 7, "to_account": 20, "amount_cents": 5000 }
Se o servidor confia no from_account que veio do cliente em vez de derivar da sessão, o usuário debita a conta de outro, id no body é exatamente tão perigoso quanto id na URL, e é pior de auditar, porque não aparece no log de acesso do balanceador.
No objeto aninhado. O endpoint pai checa o dono e o filho não:
GET /accounts/7/transactions/8817
O código valida que a conta 7 é sua e depois faz Transaction.find(8817) sem confirmar que a transação 8817 pertence à conta 7, a checagem do pai deu falsa sensação de segurança - e em revisão ela dá certo duas vezes, porque o revisor vê uma autorização acontecendo na primeira linha e para de ler, a forma segura encadeia a posse até a folha:
account = current_user.accounts.find(params[:account_id])
transaction = account.transactions.find(params[:id])
No campo que decide papel. BOLA vira BOPLA quando o objeto é seu mas o atributo não deveria ser:
PATCH /users/42
{ "name": "Maria", "role": "admin" }
Autenticado, autorizado a editar o próprio perfil, e o role estava na lista de campos aceitos, mass assignment e BOLA são o mesmo problema visto de ângulos diferentes: o cliente escreveu num atributo que ele não deveria controlar, em Rails o permit é uma allowlist e por isso funciona - desde que ninguém tenha escrito params.require(:user).permit! numa sexta-feira.
No id de dentro do payload aninhado. Este é o mais rentável em Rails e quase nunca aparece em lista de BOLA, porque o campo perigoso não é o id do recurso, é um id enterrado dois níveis abaixo:
PATCH /users/42
{ "user": { "name": "Maria",
            "account_attributes": { "id": 99, "nickname": "conta principal" } } }
Com accepts_nested_attributes_for :account, o Rails interpreta um id presente nos atributos aninhados como "atualize este registro existente", não como "crie um novo", se o registro 99 não pertence ao usuário 42, você acabou de escrever no objeto de outra pessoa através de um endpoint que edita o próprio perfil.
E o permit não segura: account_attributes: [:id, :nickname] está na allowlist porque precisa estar, senão a edição de registro existente para de funcionar, a allowlist está correta e o bug acontece mesmo assim, que é exatamente o tipo de coisa que passa em revisão, o que segura é resolver o registro a partir do dono no servidor, ou um reject_if que confirme a posse antes de deixar o id entrar.
No endpoint em lote. Este é o favorito porque a checagem existe e ainda assim falha:
POST /statements/bulk
{ "ids": [9931, 9930, 9929] }
O código valida o primeiro id, ou valida em um if que só cobre o caminho feliz, e o where(id: ids) devolve tudo, endpoint de lote precisa comparar quantidade pedida com quantidade autorizada e falhar quando diferirem, não filtrar em silêncio.
No GraphQL. A interface Node com node(id: ...) é uma superfície de BOLA por construção: um resolver genérico que busca qualquer objeto do grafo por id global, se a autorização mora nos resolvers de campo e não no carregamento do nó, o atacante alcança o objeto pelo caminho lateral, o mesmo vale para toda relação atravessada: me { account { transactions { ... } } } está autorizado, transaction(id: 8817) { account { owner { document } } } talvez não esteja.
No relatório e na exportação. GET /reports?account_id=7&format=csv é o mesmo bug com roupa de BI, endpoint de relatório costuma ser escrito fora do padrão dos controllers de recurso, com SQL montado à mão, e é onde o escopo por dono se perde primeiro.
No objeto que não parece objeto. Arquivo em bucket com URL previsível, PDF de comprovante servido por GET /files?path=..., avatar, anexo de ticket, se o download não passa pela mesma camada de autorização do recurso que ele representa, você tem BOLA em cima de um S3 público por engano.
No estado, não no dono. Objeto é seu, mas você não pode mais agir sobre ele: cancelar uma transferência já liquidada, reabrir um chamado encerrado, editar um contrato assinado, é autorização em nível de objeto também, só que a regra é a máquina de estados, scanner nenhum enxerga isso.
O padrão por trás de todos: em algum ponto o código confiou num dado que o cliente escolheu, para decidir o que o cliente pode acessar.
O problema real nº 4: a checagem existe, e está no lugar errado
Time maduro não esquece a autorização, time maduro coloca a autorização num lugar que não cobre todos os caminhos.
Os quatro lugares errados mais comuns:
No front-end. O botão some para quem não é dono, e a API continua aberta, isso não é controle de acesso, é design de interface, o cliente é território do adversário: ele lê o bundle, encontra a rota e chama direto.
No middleware por rota. Alguém escreve uma regra que casa /accounts/* e acha que cobriu tudo, aí nasce /v2/accounts, ou /internal/accounts, ou um POST /graphql que atravessa a mesma tabela sem passar pela rota protegida, autorização amarrada a padrão de URL vira dívida no primeiro versionamento de API.
No controller, uma vez por action. Melhor que os anteriores, e ainda insuficiente: cobre o caminho que o autor lembrou, o job assíncrono que reprocessa o mesmo recurso não passa pelo controller, o comando de console não passa, o endpoint interno que o time de dados criou para o dashboard não passa.
No controller, mas depois do cache. O mais cruel dos quatro, porque aqui a autorização existe, está correta e roda - só que tarde demais para importar, CDN, Rack::Cache, cache de fragmento, um Cache-Control: public distraído num endpoint autenticado: qualquer um deles faz a resposta do usuário 42 ser servida ao usuário 13 sem que uma linha do seu código execute, não é BOLA no controller, é BOLA na camada que fica na frente dele, e não aparece em teste nenhum porque em teste não tem CDN, a regra é curta: resposta que depende de identidade é private, e se for cacheada, a identidade faz parte da chave de cache.
O lugar certo é o mais perto possível do dado, em ordem crescente de garantia:
- Escopo na query -
current_user.statements.find(...), barato, idiomático, cobre o caminho da aplicação. - Camada de política explícita - Pundit, CanCan, um módulo
Authzpróprio, torna a regra legível, testável e reutilizável fora do controller. - Row Level Security no banco - a última linha, aquela que vale mesmo quando o desenvolvedor erra.
A camada de política resolve o problema de "cada endpoint reimplementa a regra", em Pundit o que importa não é o authorize do objeto único, é o policy_scope das coleções:
class StatementPolicy < ApplicationPolicy
  class Scope < ApplicationPolicy::Scope
    def resolve
      scope.joins(:account).where(accounts: { user_id: user.id })
    end
  end

  def show?
    record.account.user_id == user.id
  end
end
E o gancho que transforma isso em garantia, no ApplicationController:
after_action :verify_authorized, except: :index
after_action :verify_policy_scoped, only: :index
Essas duas linhas fazem a aplicação falhar em teste quando alguém escreve uma action nova sem autorizar, não é documentação, é um erro em CI, default-deny aplicado ao processo, não só à requisição.
E o fundo do poço, que é onde eu queria que mais times chegassem: RLS no Postgres.
ALTER TABLE statements ENABLE ROW LEVEL SECURITY;
ALTER TABLE statements FORCE  ROW LEVEL SECURITY;

CREATE POLICY statements_por_tenant ON statements
  USING (tenant_id = NULLIF(current_setting('app.tenant_id', true), '')::uuid);
Quatro detalhes desse DDL que não são estilo:
FORCE ROW LEVEL SECURITY. Sem isso, o dono da tabela ignora a política - e a sua aplicação Rails quase certamente conecta como dono da tabela, porque foi ela que rodou as migrações.ENABLEsozinho é uma proteção que não protege exatamente contra quem você precisa proteger.current_setting('app.tenant_id', true). O segundo argumento faz a função devolverNULLem vez de estourar quando a variável nunca foi definida naquela sessão.tenant_id = NULLéNULL, que a política trata como falso: conexão sem tenant definido não enxerga linha nenhuma, falha fechando.NULLIF(..., ''). Este é o detalhe que só aparece em produção, otruecobre "a variável nunca existiu nesta sessão", que é o estado de uma conexão recém-aberta, só que uma GUC customizada, uma vez definida, passa a existir na sessão com valor de reset igual a string vazia - então depois do primeiroSET LOCAL app.tenant_iddaquela conexão, o commit não devolve a variável paraNULL, devolve para''; da segunda requisição em diante, naquela conexão do pool, qualquer consulta que rode antes do próximoSET LOCALrecebe'', e''::uuidnão é falso, éinvalid input syntax for type uuid:500em vez de404, intermitente, e proporcional ao tempo de vida das conexões, oNULLIFtraz esse caso de volta paraNULL, que a política já sabe tratar como negar.SET LOCAL, nãoSET. A variável precisa ser definida por transação, dentro da transação, para não vazar entre requisições no pool de conexões.SET LOCAL app.tenant_id = ...no início de cada request, e o pool volta limpo no commit.
E agora a parte honesta, que é onde eu vejo mais time se enganar: essa política não resolve o problema com que o artigo abriu.
Ela compara tenant_id, se o usuário 42 e o usuário 13 estão no mesmo tenant - dois analistas da mesma empresa cliente, duas pessoas no mesmo produto, depende de como você modelou -, o extrato 9930 continua perfeitamente visível para os dois, a promessa de "última linha de defesa" está sendo cumprida contra o vazamento cross-tenant da seção 5, e não contra o acesso horizontal da seção 1, que é o caso que abriu o texto, vale saber qual dos dois você comprou.
Se você quer os dois, a política precisa descer ao nível de posse, e aí ela deixa de ser comparação de coluna e vira travessia de cadeia:
CREATE POLICY statements_do_dono ON statements
  USING (
    tenant_id = NULLIF(current_setting('app.tenant_id', true), '')::uuid
    AND EXISTS (
      SELECT 1 FROM accounts a
       WHERE a.id      = statements.account_id
         AND a.user_id = NULLIF(current_setting('app.user_id', true), '')::uuid
    )
  );
Isso tem preço, e o preço é real: o EXISTS entra em todo plano de execução da tabela, e sem um índice em accounts (id, user_id) ele dói, por isso a decisão certa não é "ligar RLS de posse em tudo", é escolher as duas ou três tabelas onde o vazamento vira notificação à ANPD e pagar o custo só nelas, modelo de ameaça, não gosto.
Nos dois casos, RLS não substitui o escopo na query - substituir seria pagar esse plano em todo lugar e perder legibilidade, ela existe para o dia em que alguém escreveu Statement.where(id: params[:ids]) num relatório e ninguém viu, e o valor dela é exatamente ser a única camada que não depende de alguém ter lembrado.
O problema real nº 5: o objeto é seu, o tenant não é
Este é o BOLA que mais dói em fintech e em qualquer plataforma B2B2C, e ele não aparece no exemplo didático porque o exemplo didático tem um nível de posse só.
Numa arquitetura multi-tenant, a posse é uma cadeia: usuário pertence a uma empresa, empresa a um tenant, conta a uma empresa, transação a uma conta.
Escopar pelo current_user cobre a folha e deixa o meio da cadeia aberto, o caso clássico:
# parece seguro, e é
transaction = current_user.transactions.find(params[:id])

# e no endpoint ao lado, escrito por outra pessoa, seis meses depois
company = Company.find(params[:company_id])
render json: company.transactions
O segundo endpoint confere que você está autenticado e nunca confere que a empresa params[:company_id] é do seu tenant.
O atacante é um cliente legítimo da plataforma lendo a operação do concorrente que usa o mesmo SaaS, do ponto de vista do log de acesso, é tráfego perfeitamente normal de um cliente pagante.
Três coisas que fazem diferença aqui:
- O tenant não vem do cliente, nunca. Nem em header, nem em query string, nem em claim editável, ele é derivado da sessão no servidor, um header
X-Tenant-Idque o cliente pode escrever é um BOLA com nome de feature. - A cadeia inteira é verificada, não só a ponta. Se o recurso tem três níveis de posse, existem três chances de errar, e o teste precisa cobrir cada salto isolado.
- O identificador global é o pior dos mundos. Id sequencial compartilhado entre tenants transforma qualquer BOLA num vazamento cross-tenant, se cada tenant tem seu próprio espaço de numeração, o mesmo bug vaza só dentro de casa, não é defesa, é redução de raio de explosão - e raio de explosão é o que você negocia quando o incidente acontecer.
Uma boa pergunta para levar à próxima revisão de arquitetura: quantos endpoints do sistema resolvem o tenant a partir de algo que o cliente enviou? Se você não sabe a resposta, ela é maior que zero.
O problema real nº 6: 403 conta uma história que 404 não conta
Existe uma discussão que parece bikeshedding e não é, quando o objeto não é seu, o que responder?
| Resposta | O que ela revela | Quando usar |
|---|---|---|
404 | nada | acesso horizontal, objeto de outro |
403 | o objeto existe | falta de permissão dentro do seu escopo |
401 | credencial inválida | token ausente ou expirado |
Um 403 diz "isto existe e não é seu", o que já entrega a existência do objeto, para um atacante montando um alvo, essa é a metade do trabalho: com 403 versus 404 ele enumera quais ids existem, mede o tamanho da base, descobre a taxa de crescimento por dia e sabe se a conta de uma pessoa específica está na plataforma.
404 esconde até isso: para quem não é dono, o recurso simplesmente não existe, é a mesma semântica de current_user.statements.find levantando RecordNotFound, o que é conveniente - a implementação idiomática já produz a resposta certa.
O 403 continua tendo lugar legítimo: quando o usuário sabe que o objeto existe porque ele está no escopo dele, e a negativa é de permissão, não de posse, analista que não pode aprovar a transferência que ele mesmo enxerga na tela precisa de 403, senão a interface fica mentindo.
E o canal lateral não é só o status code.
Vale checar se a resposta de negativa difere no resto:
- Tempo. Objeto inexistente responde em 3 ms e objeto de outro dono em 40 ms, porque o segundo foi carregado antes de ser negado, a diferença é um oráculo de existência.
- Corpo do erro.
{"error": "Statement not found"}versus{"error": "Not found"}, ou umerror_codedistinto, ou umtrace_idque só aparece num dos casos. - Cabeçalho.
Location,ETag,X-Request-Idcom formato diferente,Content-Lengthque varia. - Contagem e paginação. O
totalde uma listagem que inclui objetos que a listagem não devolve, vaza o número, e o número às vezes é o dado. - Rate limit. Bater em objeto inexistente não consome cota e bater em objeto real consome, sim, eu já vi.
A negativa precisa ser indistinguível, se ela varia com o fato que você está escondendo, ela não está escondendo.
O problema real nº 7: achado sem prova é opinião
Relatório de BOLA precisa demonstrar o acesso indevido, e a forma limpa de fazer isso é o teste de dois usuários.
Você precisa de duas contas de teste na aplicação, A e B, ambas autorizadas pelo escopo do engajamento, de preferência com o mesmo papel - senão você está testando BFLA sem perceber, o procedimento:
- Logado como
A, crie um recurso e anote o identificador, digamos extrato9931. - Logado como
A, acesseGET /statements/9931, deve funcionar, é o dono, guarde a resposta inteira, com cabeçalhos e tempo. - Troque só o token: envie a mesma
GET /statements/9931com o token deB. - Compare byte a byte.
A tabela de decisão é curta:
Resposta ao token de B | Leitura |
|---|---|
200 com os dados de A | BOLA confirmado |
200 com corpo vazio ou genérico | verificar campo a campo |
404 | escopado por dono, provavelmente seguro |
403 | negado explícito, vaza existência |
401 | problema de autenticação, outro teste |
O detalhe que separa o teste sério do palpite: troque só o token, mantenha o resto idêntico. Mesma URL, mesmo método, mesmo corpo, mesmos cabeçalhos, mesma ordem de campos no JSON, se a única variável é a identidade e a resposta muda de "vazou" para "negado", você isolou a falha de autorização, se você mexer em duas coisas, seu relatório vira discussão na reunião de triagem.
Três refinamentos que aumentam muito a taxa de achado:
Teste também sem token. A terceira coluna do teste é a requisição anônima, é desconfortável quantas vezes ela responde 200 num endpoint que "obviamente" exige autenticação, geralmente porque a rota nova ficou fora do before_action ou porque existe um caminho /internal que o gateway não deveria expor.
Teste os dois sentidos. Leitura vazando é ruim, escrita vazando é incidente, repita o procedimento com PATCH, DELETE e com o id no corpo, um endpoint que nega o GET e aceita o PATCH existe mais do que deveria, porque o autor da regra pensou em "ver o dado" e não em "mexer no dado".
Automatize a matriz, não os casos. O que escala é gerar o produto cartesiano de (endpoint × papel × dono do objeto) a partir da especificação OpenAPI e conferir a resposta esperada de cada célula, Burp Autorize faz isso interativamente durante a navegação; para regressão, o lugar certo é a suíte de testes do time:
# spec/requests/authorization_spec.rb
RSpec.describe "autorização em nível de objeto" do
  let(:dono)     { create(:user) }
  let(:intruso)  { create(:user) }
  let(:extrato)  { create(:statement, account: create(:account, user: dono)) }

  it "não entrega o extrato de outro usuário" do
    get "/statements/#{extrato.id}", headers: auth_headers(intruso)

    expect(response).to have_http_status(:not_found)
    expect(response.body).not_to include(extrato.account.number)
  end
end
Esse teste custa dez minutos para escrever e fica de guarda para sempre, um por família de recurso já muda o patamar de um sistema.
O problema real nº 8: o que dá para automatizar, e o que não dá
Volto à tese da abertura, agora com o que dá para fazer a respeito dela.
Nenhuma ferramenta vai te entregar a lista dos seus BOLAs, pelo motivo já dito: a regra de posse é do seu domínio e o scanner não tem como conhecê-la, mas "nenhuma ferramenta resolve" não é o mesmo que "não automatize nada", e a distância entre essas duas frases é o que separa um time que reduz a superfície de um time que só se preocupa.
O que a ferramenta consegue fazer, e vale ligar:
- Análise estática de padrão local. Uma regra de lint que reprova
Model.find(params[:id])fora de uma lista curta de exceções aprovadas, grosseiro, ruidoso e mesmo assim rentável. - Cobertura de política em CI. Os
verify_authorizedda seção 4, transformando ausência de autorização em build vermelho. - Diff de superfície. Comparar a especificação OpenAPI entre releases e falhar quando um endpoint novo aparece sem teste de autorização correspondente, endpoint sem inventário é endpoint sem dono, e é neles que a falha mora.
Repare no que os três têm em comum: nenhum deles procura a vulnerabilidade, os três procuram a ausência do controle. Query fora do padrão, action sem política, endpoint sem teste, você não consegue automatizar "este objeto é de outra pessoa", que exige o domínio, consegue automatizar "aqui ninguém chegou a perguntar de quem é", que não exige nada além de disciplina de forma - e é por isso que essa é a única automação que funciona.
O resto é hábito de arquitetura: escopar toda query pela identidade da sessão, tratar id do cliente como entrada não confiável mesmo quando parece interno, e revisar cada endpoint com uma pergunta só - se eu trocar esse id pelo de outra pessoa, o que acontece?
E não é teoria, a lista de vazamentos grandes causados por essa falha é constrangedoramente banal:
| Caso | Ano | O que era |
|---|---|---|
| First American Financial | 2019 | id sequencial de documento, sem autenticação |
| USPS Informed Visibility | 2018 | API devolvia dado de qualquer conta |
| Peloton | 2021 | perfil de qualquer usuário por id |
| Parler | 2021 | post por id sequencial, API sem auth |
| Optus | 2022 | endpoint exposto com identificador incremental |
Nenhum deles precisou de exploit, precisou de um for e de paciência.
Bônus: três coisas chamadas "autorização" na mesma base
Termino com um problema que não é uma falha, é uma ambiguidade - e que por isso não entra em taxonomia nenhuma, apesar de eu já ter visto custar meio dia de incidente.
Em boa parte das bases que eu leio, a palavra "autorização" já está ocupada, existe um AuthorizationService que valida token, existe um método authorize! que só confere se a sessão está ativa, existe um middleware Authorization que é, na verdade, autenticação, em fintech ainda tem a terceira acepção, que é a do domínio: "autorizar uma transação" no sentido do adquirente, aprovar a compra no cartão.
Três conceitos, um nome, aí alguém lê if authorized? num controller, entende "a posse foi verificada", e segue em frente.
Separe o vocabulário enquanto custa um rename: authenticate para identidade, authorize para permissão sobre objeto, e o termo do domínio - capture, approve, settle - para a transação, nomeação não é firula quando o nome errado faz o revisor pular a checagem que ele acha que já viu.
Meia hora, um grep e um número
Nada de checklist, um exercício que produz um número, porque número move reunião e pergunta retórica não move.
Rode alguma variação disto na sua base:
grep -rEn '\b[A-Z][A-Za-z0-9_]*\.(find|find_by|where)\(' app/ \
  | grep -E 'params\[' \
  | grep -vE 'current_user|current_account|policy_scope|authorize' \
  | tee /tmp/candidatos-bola.txt \
  | wc -l
Ajuste para o seu framework e para os seus nomes de sessão, o que importa é a forma: modelo consultado direto, com valor vindo do cliente, sem passar por um escopo de identidade.
Candidato não é bug, metade vai ser recurso legitimamente público, tabela de domínio, busca de CEP, catálogo, a outra metade é o trabalho.
O que o número diz:
| Linhas | Leitura |
|---|---|
| zero | ou você escopa tudo, ou o grep está errado. Aposte no segundo e confira com uma action que você sabe que é insegura |
| menos de dez | dá para revisar uma a uma nesta semana, e deixar um teste de regressão por família de recurso |
| dezenas | não revise, mude o padrão. verify_authorized em CI primeiro, e a lista vira backlog ordenado por sensibilidade do dado |
| centenas | o problema não é a lista, é não existir caminho seguro por padrão. RLS nas tabelas que doem, antes de qualquer refactor de controller |
E o mais importante: o grep só acha a forma canônica. Os cinco que ele nunca vai encontrar, e que você tem que caçar a mão, são justamente os que este artigo passou o tempo todo descrevendo:
- o
idno corpo doPOST, porque não existeparams[:id]visível - o
iddentro de_attributesaninhado, porque opermitestá correto e o bug acontece assim mesmo - a folha de um recurso aninhado, porque o pai foi checado e a linha parece autorizada
- o endpoint de lote, porque a checagem existe e cobre um item só
- a máquina de estados, porque o objeto é seu e mesmo assim aquela ação não é
Se o grep devolveu pouca coisa e você ficou tranquilo, esses cinco são o motivo para não ficar.
Autenticar é a porta, autorizar em nível de objeto é a fechadura de cada gaveta, a maioria dos sistemas tranca a porta com muito capricho e deixa as gavetas abertas.
Referências
- OWASP API Security Top 10 (2023) - API1:2023 Broken Object Level Authorization - a definição canônica, com exemplos de cenário e recomendações.
- OWASP API Security Top 10 (2023) - API3:2023 Broken Object Property Level Authorization - fusão de mass assignment com exposição excessiva de dados.
- OWASP API Security Top 10 (2023) - API5:2023 Broken Function Level Authorization - o irmão vertical do BOLA.
- OWASP API Security Top 10 (2019) - API1:2019 - mesma primeira posição, quatro anos antes.
- CWE-639 - Authorization Bypass Through User-Controlled Key - o identificador técnico para citar em relatório.
- CWE-566 - Authorization Bypass Through User-Controlled SQL Primary Key - a variante que casa com o
find(params[:id]). - CWE-284 - Improper Access Control e CWE-863 - Incorrect Authorization - as categorias mais amplas.
- OWASP Authorization Cheat Sheet - default-deny, centralização da decisão e verificação em todo caminho.
- PostgreSQL - Row Security Policies - documentação de RLS, incluindo o comportamento de
FORCEpara o dono da tabela. - Pundit -
policy_scope,verify_authorizedeverify_policy_scoped. - RFC 9562 - Universally Unique IDentifiers (UUIDs) - estrutura das versões 4, 6, 7 e 8, útil para avaliar o que é imprevisível de fato.
- PortSwigger Web Security Academy - Access control vulnerabilities and privilege escalation - laboratórios gratuitos para praticar o teste de dois usuários em ambiente autorizado.
Footnotes
-
RFC 9562 (2024), que substituiu a RFC 4122 e padronizou v6, v7 e v8, a v7 reserva 48 bits para timestamp Unix em milissegundos e deixa 74 bits de aleatoriedade - continua sendo muito, mas o prefixo deixa de ser segredo, e prefixo conhecido é o que transforma varredura em algo viável quando existe qualquer oráculo de tempo. ↩