Você deixou o cliente escolher uma URL, o servidor obedeceu e foi buscar a credencial da sua própria infra.
O campo é inofensivo: "URL de callback do webhook", "logo da empresa por link", "importar planilha de uma URL".
O usuário digita um endereço, seu backend faz um GET, e você acabou de dar a ele um navegador rodando dentro da sua VPC.
SSRF - Server-Side Request Forgery - é a vulnerabilidade em que o atacante não acessa o recurso interno diretamente, ele convence o seu servidor a acessar por ele, e o servidor tem tudo que o atacante não tem: está dentro da rede, passa pelo firewall, tem rota para o banco, e na nuvem tem acesso a um endereço muito específico que devolve credencial para quem pedir.
O conselho que circula sobre isso quase sempre para na primeira linha de defesa: "valide a URL", "bloqueie 169.254.169.254", "não aceite localhost", está tudo certo e tudo é insuficiente, porque cada uma dessas frases descreve uma checagem sobre texto, e o servidor age sobre IP resolvido no momento da conexão. São coisas diferentes, e o atacante mora exatamente nessa diferença.
Eu vejo essa classe em API financeira o tempo todo, porque fintech é feita de integração: webhook para notificar parceiro, callback de adquirente, fetch de comprovante, importação por link, validação de chave pública de um parceiro OIDC, todo lugar onde o servidor busca uma URL que veio de fora é um candidato, vou escrever o que realmente acontece, por que a defesa óbvia falha em cinco frentes diferentes, qual é a defesa que segura, e como você prova sem derrubar nada.
Aviso de escopo: engenharia de segurança, não receita de ataque, todo teste aqui pressupõe autorização - contrato de pentest ou política de um programa, apontar o servidor de outra pessoa para a rede interna dela sem permissão é invasão, não pesquisa.
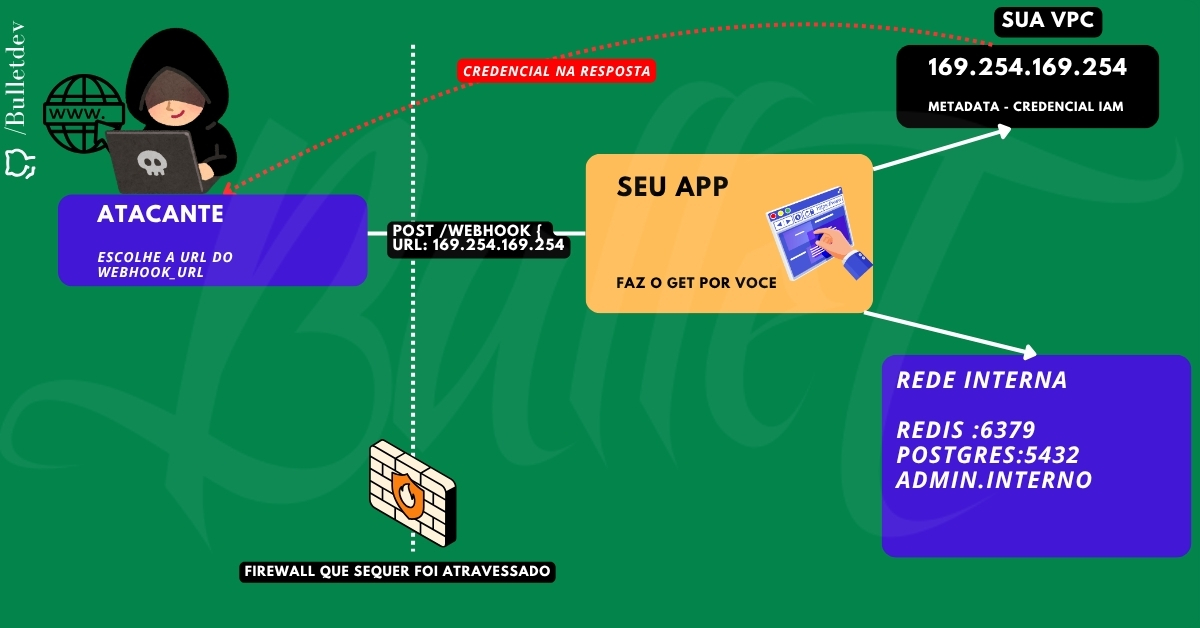
Fig. 1 - O firewall funcionou perfeitamente, a requisição partiu de dentro.
O atacante não entra na rede, ele manda o seu servidor entrar
A pergunta que define SSRF é uma só: quem faz a requisição de saída?
Quando o seu backend recebe { "webhook_url": "https://parceiro.com/hook" } e vai lá buscar ou notificar, quem origina o tráfego é o servidor, não o cliente, o servidor está num lugar privilegiado: dentro da rede, com rota para banco, para cache, para painel interno, e na nuvem para um endereço que veio assombrar todo mundo.
Troque a URL do parceiro por um alvo interno:
{ "webhook_url": "http://169.254.169.254/latest/meta-data/iam/security-credentials/" }
Esse 169.254.169.254 é o endpoint de metadados da instância na AWS, GCP e Azure, em IMDSv1, um GET sem nenhum cabeçalho devolve o nome da role, e um segundo GET devolve as credenciais temporárias dela, o atacante nunca tocou na sua rede, ele digitou uma URL num campo de formulário e o seu servidor buscou a chave.
Onde a chave aparece depois muda o quanto o bug vale, e é por isso que existem três sabores:
| Tipo | O que você vê | Como se confirma |
|---|---|---|
| SSRF refletida | o corpo da resposta remota | direto, o dado volta |
| SSRF semi-cega | status, tamanho, tempo | por diferença entre alvos |
| SSRF cega | nada | por callback num coletor seu |
A cega é a mais comum em webhook, porque o produto não tem motivo nenhum para te mostrar o que o parceiro respondeu, e é a mais perigosa de subestimar: "não retorna nada" vira "baixo impacto" no relatório, quando na prática ela ainda alcança tudo que é POST, tudo que muda estado, e tudo que pode ser exfiltrado por DNS.
SSRF transforma "meu servidor faz requisições HTTP" em "o atacante faz requisições HTTP a partir de dentro".
O problema real nº 1: o alvo não é só o metadata, é tudo que o firewall protegia
O endpoint de metadados é o troféu porque a recompensa é credencial, mas SSRF não para nele, de dentro da rede, o servidor alcança o que o mundo externo nunca alcança:
- Serviços internos sem autenticação. Painel de admin que "só a rede interna acessa", Elasticsearch na 9200, Redis na 6379, Kibana, Consul, Prometheus, Jenkins, actuator do Spring Boot na 8080, Kubelet na 10250, banco exposto internamente, a rede era a autenticação, e você acabou de furá-la.
- Cloud metadata. Credencial de role IAM na bandeja, mais
user-data, que costuma ter variável de ambiente, senha de banco e token de deploy porque alguém achou que aquilo era privado. - Varredura de porta interna. Diferença de tempo ou de mensagem de erro entre
http://10.0.0.5:8080ehttp://10.0.0.5:9999mapeia o que está vivo lá dentro, mesmo em SSRF cega, conexão recusada volta em milissegundos; porta filtrada estoura o timeout, isso é um oráculo binário, e um oráculo binário mapeia uma/24inteira. - Outros esquemas. Se o cliente HTTP segue
file://, você lê/etc/passwd,/proc/self/environe o token da service account do Kubernetes em/var/run/secrets/kubernetes.io/serviceaccount/token, se seguegopher://, você fala protocolo cru com o Redis e transforma uma leitura em escrita arbitrária.dict://,ftp://,ldap://ejar://têm variações do mesmo tema. - O SSRF que não sai da máquina.
http://127.0.0.1:8500,http://[::1]:9200, o socket do Docker, aplicação em container costuma ter vizinhos interessantes no mesmo host.
Num sistema financeiro isso é grave de um jeito específico: a credencial IAM vazada costuma dar acesso a bucket com comprovante e documento de KYC, fila de liquidação, base de transação, não é "leram um arquivo interno", é "assumiram a identidade da aplicação na nuvem", foi exatamente essa cadeia que produziu o vazamento da Capital One em 2019, com dado de cerca de 100 milhões de pessoas nos EUA e 6 milhões no Canadá: SSRF a partir de um WAF mal configurado (ModSecurity) rodando em EC2, IMDSv1 respondendo sem token, credencial da role da instância, leitura dos buckets S3, repare no primeiro elo, porque ele é desconfortável: a peça vulnerável era o controle de segurança.
A rede interna nunca foi uma fronteira de segurança, SSRF só prova isso na prática.
O problema real nº 2: bloquear por lista negra de IP não funciona, e dá para mostrar por quê
A defesa que todo mundo escreve primeiro é filtrar a URL: "se aponta para 169.254.169.254, 127.0.0.1 ou 10.x, recusa", parece razoável e é furado em pelo menos cinco frentes independentes - o que importa não é uma delas, é o fato de serem cinco, porque significa que a próxima também existe e você ainda não a conhece.
1. Representações alternativas do mesmo IP. Um endereço IPv4 é um inteiro de 32 bits, e praticamente toda biblioteca de rede aceita as formas históricas de escrever esse inteiro:
| Forma | 169.254.169.254 |
|---|---|
| decimal pontuado | 169.254.169.254 |
| inteiro decimal | 2852039166 |
| hexadecimal | 0xA9FEA9FE |
| octal | 0251.0376.0251.0376 |
| misto | 0xA9FE.43518 |
Sua regex que procura o texto 169.254 não pega nenhuma das quatro últimas, o sistema operacional resolve todas para o mesmo lugar, porque inet_aton sempre aceitou esse formato e ninguém vai remover isso agora.
2. Localhost tem muitos nomes. 127.0.0.1, 127.1, 127.0.1, 0.0.0.0, [::1], [::], localhost, localtest.me, e qualquer domínio que alguém aponte para loopback de propósito, o bloco de loopback é uma /8 inteira: são 16 milhões de endereços que respondem na mesma máquina.
3. DNS que você não controla. O atacante registra evil.com e faz o registro responder um IP público na hora da sua validação e 169.254.169.254 na hora do fetch, é o DNS rebinding, que é um TOCTOU clássico: você valida um IP e conecta em outro, porque resolveu duas vezes, não precisa nem de infraestrutura própria - serviços como nip.io e sslip.io devolvem qualquer IP embutido no nome, e ferramentas públicas de rebinding alternam duas respostas a cada consulta.
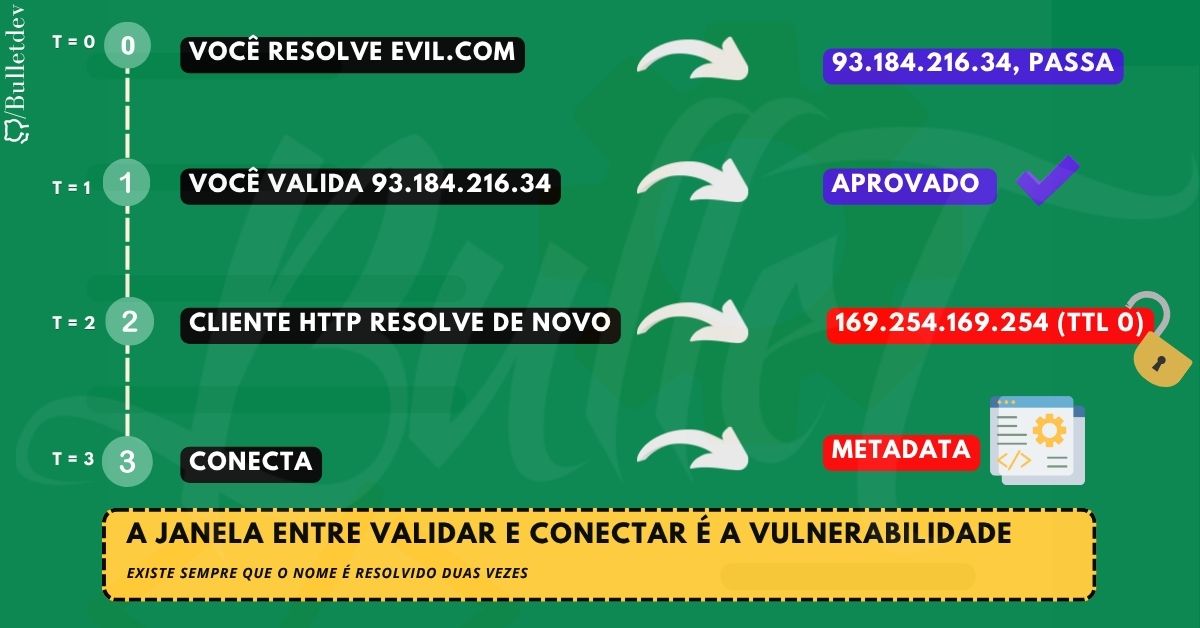
Fig. 2 - A janela entre validar e conectar é a vulnerabilidade, ela existe sempre que o nome é resolvido duas vezes.
4. Redirect. Você valida https://inocente.com, o servidor remoto responde 302 Location: http://169.254.169.254/latest/meta-data/, e o cliente HTTP segue obedientemente, validou a URL de entrada e ignorou para onde ela levou, este é o bypass mais fácil de todos, porque não exige nenhum truque de parsing: exige só que o atacante controle um servidor na internet, o que ele controla.
5. IPv6, mapeamentos e tradução. [::ffff:169.254.169.254] é o mesmo endereço em forma mapeada, [::ffff:a9fe:a9fe] é o mesmo em hexadecimal, e a AWS ainda publica o metadata em [fd00:ec2::254], filtro escrito pensando só em IPv4 não vê nada disso.
E tem um caso que sobrevive até a quem tratou os mapeamentos, porque ele não é um IPv4 disfarçado de IPv6, é um IPv4 traduzido: o prefixo NAT64 bem conhecido, 64:ff9b::/96, em qualquer rede com NAT64 e DNS64 - o que inclui cluster EKS IPv6-only, boa parte de operadora móvel e várias VPCs modernas -, [64:ff9b::a9fe:a9fe] chega no metadata, quem escreveu a blocklist olhando a lista de faixas privadas do RFC 1918 e os equivalentes IPv6 não tem esse prefixo, porque ele não é privado: é um bloco global reservado para tradução; acrescente 2002::/16, o 6to4, pelo mesmo motivo.
Esse quinto item é a melhor ilustração do argumento da seção inteira, não é que você esqueceu uma faixa, é que a lista de formas de escrever "o mesmo destino" cresce com o tempo, por decisão de gente que não está pensando na sua blocklist.
O padrão por trás de todas: você validou o texto da URL e o servidor agiu sobre o IP resolvido no momento da conexão.
O problema real nº 3: o seu parser de URL e o seu cliente HTTP discordam
Este é o furo que sobrevive ao time que fez tudo certo na seção anterior, e é o mais bonito dos cinco porque não depende de você ter esquecido nada, depende de duas bibliotecas lerem a mesma string de forma diferente.
Quase toda validação segue esta forma:
host = urlparse(url).hostname      # biblioteca A decide qual é o host
if not permitido(host):
    raise Recusado
requests.get(url)                  # biblioteca B decide de novo, do zero
A validação e a conexão fazem parsing independentes da mesma string, se A e B discordarem em qualquer caso de borda, a checagem inteira vira decoração, e elas discordam, porque a URL é um formato com 30 anos de retrocompatibilidade e três especificações concorrentes - RFC 3986, o WHATWG URL Standard e o que cada implementação fez antes de existir padrão.
Os casos que mais aparecem:
| String | O que A costuma ver | O que B costuma conectar |
|---|---|---|
http://parceiro.com@169.254.169.254/ | parceiro.com | 169.254.169.254 |
http://169.254.169.254#@parceiro.com/ | parceiro.com | 169.254.169.254 |
http://parceiro.com\n@169.254.169.254/ | erro ou parceiro.com | varia |
http://parceiro.com:80@internal:8080/ | parceiro.com | internal |
O primeiro é o userinfo do RFC 3986: tudo antes do @ é usuário e senha, não host, um parser desatento lê da esquerda para a direita e encontra parceiro.com primeiro, um cliente HTTP correto lê o último @ e conecta no que vem depois.
E existe um caso que não cabe na tabela, porque ele não é uma string malformada, é uma string que muda de identidade dependendo de quem a lê: um domínio escrito com alfanuméricos circundados, do tipo ⓟⓐⓡⓒⓔⓘⓡⓞ.com. Sob NFC ele continua sendo exatamente aquilo, sob NFKC ele vira parceiro.com, e a divergência entre bibliotecas do mesmo ecossistema é mais direta do que qualquer linha acima: o pacote idna, que implementa IDNA 2008, recusa o nome com InvalidCodepoint; o str.encode("idna") embutido no Python, que é IDNA 2003 e ainda faz nameprep, aceita e devolve parceiro.com.
Uma recusa, a outra resolve silenciosamente para outro host, e a pergunta que decide o seu caso é qual das duas respondeu quando a sua allowlist de domínio foi consultada.
Esse território foi mapeado em detalhe pelo Orange Tsai em A New Era of SSRF (Black Hat USA 2017), que mostrou o mesmo tipo de divergência entre libcurl, o parser do PHP, o do Python, o do Java e o do Ruby, a conclusão prática dele é a única que interessa aqui:
Se a coisa que valida e a coisa que conecta não são a mesma coisa, você não validou nada.
A defesa não é achar um parser perfeito, é eliminar a segunda análise: você resolve, você decide, e você entrega ao cliente HTTP um IP já escolhido, não uma string para ele reinterpretar, é a próxima seção.
O problema real nº 4: a defesa que segura mora no destino, não na entrada
SSRF não se resolve limpando a entrada, resolve-se controlando a saída, em ordem de eficácia:
1. Allowlist, não blocklist. Não tente enumerar tudo que é proibido, você vai esquecer uma representação - a seção 2 tem cinco famílias e não é exaustiva, liste o que é permitido: os domínios ou IPs específicos com que a aplicação legitimamente fala, tudo fora, recusa, blocklist é você contra a criatividade do atacante; allowlist é o atacante contra uma porta fechada.
A objeção imediata é real: webhook de cliente é destino arbitrário por definição, não dá para fazer allowlist de domínio, certo - e é por isso que allowlist de domínio e allowlist de faixa de IP são controles diferentes, webhook de cliente pode ir para qualquer domínio, desde que resolva para um IP público que não seja seu, isso continua sendo allowlist, só que sobre o espaço de endereçamento.
2. Resolva o DNS uma vez e conecte naquele IP. Mata rebinding e mata o parser differential de uma vez só, porque o cliente HTTP deixa de receber um nome para reinterpretar.
3. Não siga redirect, ou revalide cada salto. O caso simples é desligar o follow e tratar 3xx como resposta, não como instrução, se o produto precisa seguir, cada salto passa pela mesma checagem de IP, com um limite baixo de saltos.
4. Recuse toda faixa que não é internet pública. Depois de resolver, não só as óbvias:
| Faixa | O que é |
|---|---|
0.0.0.0/8 | "esta rede", resolve para local |
10.0.0.0/8, 172.16.0.0/12, 192.168.0.0/16 | privadas |
100.64.0.0/10 | CGNAT, usada por várias VPCs |
127.0.0.0/8 | loopback inteiro |
169.254.0.0/16 | link-local, inclui o metadata |
192.0.0.0/24, 198.18.0.0/15 | uso especial e benchmark |
224.0.0.0/4, 240.0.0.0/4 | multicast e reservado |
::/128, ::1/128, fc00::/7, fe80::/10 | não especificado, loopback, ULA e link-local IPv6 |
64:ff9b::/96, 2002::/16 | NAT64 e 6to4, o IPv4 inteiro por dentro |
As duas últimas linhas são as que faltam em quase toda implementação, e são as da seção 2, item 5: elas não bloqueiam uma faixa interna, bloqueiam um caminho de tradução que devolve o IPv4 inteiro, incluindo o metadata, por dentro de um endereço IPv6 global.
5. Feche a porta do metadata na origem. Exija IMDSv2, bloqueie a rota, ou os dois.
6. E uma que não é defesa, é desconto no preço do bug: não devolva a resposta remota ao chamador. A tabela lá do começo separa refletida, semi-cega e cega por um critério só, quanto o atacante enxerga de volta, isso quase sempre é decisão de produto, não de segurança: alguém colocou o corpo da resposta do webhook na tela de debug do cliente porque era útil no suporte, tirar de lá transforma um SSRF refletido, que entrega credencial de IAM em texto puro, num SSRF cego, que ainda é grave mas exige um canal lateral para cada byte, não conserta nada e derruba o impacto em uma ordem de grandeza, o que é bastante para uma linha de código.
Em Ruby, a versão que junta tudo isso cabe numa tela:
require "resolv"
require "ipaddr"
require "net/http"

class DestinoRecusado < StandardError; end

TETO_RESPOSTA = 5 * 1024 * 1024

FAIXAS_PROIBIDAS = %w[
  0.0.0.0/8 10.0.0.0/8 100.64.0.0/10 127.0.0.0/8 169.254.0.0/16
  172.16.0.0/12 192.0.0.0/24 192.168.0.0/16 198.18.0.0/15
  224.0.0.0/4 240.0.0.0/4
  ::/128 ::1/128 fc00::/7 fe80::/10 64:ff9b::/96 2002::/16
].map { |faixa| IPAddr.new(faixa) }

def publico?(endereco)
  ip = IPAddr.new(endereco)
  ip = ip.native if ip.ipv6? && ip.ipv4_mapped?   # ::ffff:169.254.169.254 -> 169.254.169.254
  FAIXAS_PROIBIDAS.none? { |faixa| faixa.include?(ip) }
end

def enderecos_de(host)
  IPAddr.new(host)    # já veio literal na URL, não há segunda resolução para divergir
  [host]
rescue IPAddr::InvalidAddressError
  Resolv.getaddresses(host)
end

def busca_externa(url_bruta)
  uri = URI.parse(url_bruta)
  raise DestinoRecusado, "esquema #{uri.scheme}" unless %w[http https].include?(uri.scheme)

  host = uri.host.to_s.delete_prefix("[").delete_suffix("]")   # [::1] -> ::1
  enderecos = enderecos_de(host)
  raise DestinoRecusado, "sem resolução" if enderecos.empty?
  raise DestinoRecusado, "resolve para faixa interna" unless enderecos.all? { |e| publico?(e) }

  http = Net::HTTP.new(uri.host, uri.port)
  http.ipaddr       = enderecos.first   # conecta neste IP, não resolve de novo
  http.use_ssl      = uri.scheme == "https"
  http.open_timeout = 2
  http.read_timeout = 5
  http.max_retries  = 0

  http.request(Net::HTTP::Get.new(uri)) do |resposta|
    raise DestinoRecusado, "redirect para #{resposta["location"]}" if resposta.is_a?(Net::HTTPRedirection)

    corpo = +""
    resposta.read_body do |pedaco|
      corpo << pedaco
      raise DestinoRecusado, "resposta acima do teto" if corpo.bytesize > TETO_RESPOSTA
    end
    return corpo
  end
end
Seis pontos desse código não são estilo:
http.ipaddr =. É a linha que fecha o TOCTOU.Net::HTTPconecta no IP fornecido e ainda usauri.hostpara o cabeçalhoHoste para o SNI do TLS, então o certificado continua sendo validado contra o nome, sem ela, oNet::HTTPresolveria o nome de novo e você teria validado uma resolução e usado outra.enderecos.all?, nãoenderecos.find. Se o nome resolve para um IP público e um interno, a resposta certa é recusar tudo, escolher "o que passou" é dar ao atacante o controle da escolha: ele só precisa incluir um IP bom na lista.enderecos_detrata IP literal antes de tentar resolver. Sem esse desvio,http://169.254.169.254/cai emResolv.getaddresses, que não resolve um literal, devolve lista vazia e recusa com "sem resolução", falha fechando, então não é buraco, mas a mensagem mente: quem for testar a própria implementação vai ver o erro errado e concluir que o filtro de faixa não está funcionando, controle que recusa pelo motivo errado é controle que alguém vai "consertar" na próxima refatoração.Net::HTTP#requestnão segue redirect. Isso é comportamento padrão da biblioteca e aqui é uma vantagem: o3xxvira erro explícito em vez de virar um segundo fetch não validado, bibliotecas de mais alto nível seguem por padrão, e é onde a defesa costuma vazar.- Timeouts curtos e
max_retries = 0. Timeout longo é o que transforma SSRF cega em scanner de porta confortável, e retry multiplica cada tentativa do atacante. read_bodyem bloco, com teto de bytes.read_timeoutmede o intervalo entre pedaços, não o tamanho total: um alvo interno que devolve uma tabela de 10 GB, ou um endpoint que cospe um pedaço por segundo para sempre, respeita o timeout e come o worker, ler em streaming e abortar no teto é a diferença entre umraisee um incidente de disponibilidade causado pela sua própria defesa.
O que esse código ainda não resolve, e é honesto dizer: ele não protege contra rebinding se algo entre você e o destino resolver de novo - um proxy HTTP no meio, por exemplo, em arquitetura de container, a resposta mais robusta não é código nenhum: é egress dedicado. Todo tráfego de saída iniciado por conteúdo de usuário passa por um proxy próprio, numa subnet sem rota para a rede interna e sem acesso ao metadata, com política de destino centralizada, aí a aplicação pode errar a validação e não alcança nada.
A regra: decida sobre o IP de destino no instante da conexão, com uma lista do que é permitido, nunca sobre o texto que o cliente enviou.
O problema real nº 5: IMDSv2 não é automático, e cada nuvem tem a sua porta
A mitigação mais barata de todas é fechar o metadata, e ela é barata porque não exige tocar em uma linha de aplicação, só que "usar IMDSv2" não é um botão global, é configuração por instância, por template e por container - e o padrão herdado de instância antiga continua permitindo v1.
Como cada nuvem se comporta:
| Nuvem | Endereço | O que exige |
|---|---|---|
| AWS IMDSv1 | 169.254.169.254 | nada, GET puro |
| AWS IMDSv2 | 169.254.169.254 | PUT para obter token, depois header |
| GCP | metadata.google.internal | header Metadata-Flavor: Google |
| Azure | 169.254.169.254/metadata | header Metadata: true |
| Alibaba | 100.100.100.200 | nada, na configuração antiga |
A diferença prática: IMDSv2 exige um PUT com X-aws-ec2-metadata-token-ttl-seconds para obter um token, e depois um GET carregando esse token num cabeçalho, um SSRF que só consegue disparar um GET sem controle de método nem de cabeçalho para aí, GCP e Azure conseguem o mesmo efeito com um cabeçalho obrigatório, pelo mesmo motivo: cabeçalho customizado é o que um SSRF simples não controla.
Três armadilhas nessa configuração:
HttpTokens: requiredprecisa ser exigido, não oferecido. Instância comoptionalaceita v1 e v2, verifique comaws ec2 describe-instances --query 'Reservations[].Instances[].MetadataOptions'e trateoptionalcomo achado.HttpPutResponseHopLimitderruba container. O padrão de 1 significa que o pacote não sobrevive ao salto extra da rede do container, então o time aumenta para 2 para o pod funcionar - e volta a expor o metadata a qualquer processo do container, se a carga precisa de credencial, o caminho certo é IRSA ou Workload Identity, não aumentar o hop limit.- SSRF que controla método ou cabeçalho derrota o v2. Endpoint que aceita
{"method": "PUT", "headers": {...}}no webhook, ou uma primitiva porgopher://, faz o fluxo de duas etapas, IMDSv2 sobe o custo, não zera.
E a defesa que não depende de nenhuma dessas caixas de seleção: bloqueie a rota para 169.254.169.254 de dentro de todo container que não precisa dela. Uma regra de rede é mais fácil de auditar do que a matriz de configuração de trinta templates.
O problema real nº 6: os campos de URL que ninguém chama de campo de URL
Se você procurar por url no schema da API, vai encontrar metade dos casos, a outra metade é o que faz esse bug durar.
- Renderização de HTML para PDF. Gerador de boleto, contrato, extrato, o motor busca
<img src>,<link>, e às vezes segue<iframe>, HTML entrando no gerador é URL entrando no servidor. - Processamento de imagem. ImageMagick com delegates habilitados busca URL, SVG enviado por usuário carrega referência externa e, dependendo do renderizador, entidade XML.
- XML de qualquer tipo. XXE e SSRF são vizinhos: uma entidade externa é uma requisição de saída, em fintech isso aparece em integração de NF-e, retorno de arquivo de banco e SAML.
jwks_urie OIDC discovery. Se o produto deixa o cliente configurar um provedor de identidade, ele te dá uma URL que o servidor vai buscar em cada validação de token, é SSRF autenticado, recorrente e com cara de configuração legítima.- Metadata de SAML por URL. Mesma história, com o agravante de ser configurado uma vez e nunca mais revisado.
- Integração com "URL do seu sistema". Callback de ERP, endpoint de conciliação do cliente, URL de notificação de status de pagamento, em API financeira este é o campo mais comum de todos.
- Proxy e encurtador internos.
GET /proxy?url=...que alguém criou para contornar CORS no front, é SSRF nomeado, documentado e com uso legítimo. - Importação por link. Planilha de cobrança, lote de pagamento, arquivo de retorno, e o pior primo dele: importação que aceita
file://porque o mesmo código serve upload local.
O exercício vale a pena: liste todos os pontos do sistema em que o servidor faz uma requisição de saída cujo destino depende de algo enviado por usuário, se a lista tem um item, você tem um controle para escrever, se tem doze, você precisa de um cliente HTTP centralizado, porque doze implementações independentes de validação vão divergir.
O problema real nº 7: como eu provo, sem varrer a rede de ninguém
SSRF cega assusta porque o servidor busca a URL mas não te mostra a resposta, você precisa confirmar que a requisição de saída aconteceu sem depender de ver o corpo, a forma limpa e não destrutiva:
- Suba um coletor que você controla. Um endpoint com log, num domínio seu, ou um serviço de interação autorizado pelo escopo, anote uma URL única, com um token no path para correlacionar com a requisição que você enviou.
- Ponha essa URL no campo suspeito.
webhook_url,avatar_url,import_from,jwks_uri, o que o endpoint aceitar. - Espere o hit. Se o servidor bater lá, você tem SSRF confirmado: a requisição partiu de dentro, o IP de origem no seu log é o egress da infra do alvo, não o seu.
A tabela de decisão:
| Sinal no coletor | Leitura |
|---|---|
| HTTP, IP de egress do alvo | SSRF confirmado |
| só DNS, sem HTTP | resolve e não conecta, meia porta |
| nada, erro imediato | provável validação de entrada |
| nada, timeout longo | pode estar tentando alcançar algo |
O caso "só DNS" merece atenção, porque costuma ser lido como "não é vulnerável" e não é isso, significa que alguma coisa resolveu o nome - a própria validação, quase sempre, isso já confirma que existe resolução controlada pelo cliente, que é o pré-requisito do rebinding, e já entrega um canal de exfiltração por DNS quando houver qualquer dado para embutir no subdomínio.
O que fecha o achado sem escalar nada:
- Um controle negativo. Mande uma URL de um domínio que não existe e confirme que não há hit, sem isso, você não sabe distinguir o seu tráfego de um scanner qualquer que passou pelo coletor.
- Correlação por token único. Um path diferente por tentativa, para amarrar cada hit à requisição exata que o gerou, isso é o que sobrevive à pergunta "como você sabe que foi o nosso servidor?".
- Registro do IP de origem e do User-Agent. O User-Agent quase sempre entrega a biblioteca HTTP usada, e a biblioteca usada diz quais bypasses são plausíveis.
python-requests/2.xeGo-http-client/1.1têm comportamentos de redirect diferentes.
Repare no que este teste não faz: não aponta para o 169.254.169.254 de produção, não varre a rede interna do cliente, não tenta extrair credencial, ele demonstra a primitiva - "seu servidor busca URL arbitrária que eu forneço" - contra infra que eu controlo, a prova da existência da falha não exige explorar o pior caso, e num relatório sério a primitiva demonstrada mais a descrição do impacto máximo vale mais do que uma credencial roubada fora do escopo.
Você prova a capacidade sem pilotar o dano, o impacto máximo você descreve, a existência você demonstra contra si mesmo.
Bônus: SSRF que sai da sua rede e entra na de outro
Uma consequência que quase nunca entra no modelo de ameaça, e que em plataforma de pagamento é contratual antes de ser técnica.
O seu servidor tem reputação: o IP de egress é seu, o certificado é seu, o User-Agent tem o nome do seu produto, quando alguém usa a sua funcionalidade de webhook para bater em terceiros, quem aparece no log da vítima é você, isso vira três problemas de uma vez: o seu IP entra em lista de bloqueio, o seu jurídico recebe uma notificação, e o seu time de suporte descobre pelo Twitter.
Some a isso a amplificação: um endpoint que aceita URL e é chamável sem custo é um refletor, se o atacante consegue disparar mil requisições suas contra um alvo, ele terceirizou o tráfego dele para a sua infraestrutura, com a sua conta de rede.
Vale por dois controles baratos que quase ninguém liga: limite de taxa por origem no cliente HTTP de saída, e User-Agent identificável com um endpoint de contato, para que a vítima do outro lado saiba a quem reclamar antes de bloquear a sua faixa inteira.
O que fazer na segunda-feira
Sem checklist genérico, seis perguntas que, respondidas honestamente, dizem o tamanho do seu problema:
- Quantos lugares do sistema fazem requisição de saída com destino escolhido por usuário? Se você não consegue listar, esse é o primeiro trabalho, e ele é de inventário, não de código.
- Existe um cliente HTTP único para esse tráfego, ou cada time escreveu o seu? N implementações significam N validações diferentes e uma delas está errada.
- A validação e a conexão usam o mesmo IP, resolvido uma vez? Se o código valida uma string e passa a mesma string para a biblioteca, você tem TOCTOU e parser differential ao mesmo tempo.
- O que acontece com um
302para169.254.169.254? Se ninguém sabe, teste hoje contra o seu próprio ambiente, é o bypass mais fácil e o mais comum. - Todas as instâncias exigem IMDSv2, e nenhum container tem hop limit 2 sem precisar? Uma query no seu inventário responde, e o resultado costuma ser desconfortável.
- O tráfego de saída gerado por conteúdo de usuário sai por uma rota sem acesso à rede interna? Se sai pela mesma rota do resto, a sua única defesa é a validação - e a seção 2 tem cinco motivos para não confiar só nela.
Você não controla o que o cliente digita, você controla para onde o seu servidor conecta, a segurança inteira mora nesse segundo verbo.
Referências
- OWASP API Security Top 10 (2023) - API7:2023 Server Side Request Forgery - a entrada dedicada ao problema em API, com cenários de webhook.
- OWASP Top 10 (2021) - A10:2021 Server-Side Request Forgery - a categoria que entrou no Top 10 por votação da comunidade, não por dados.
- OWASP SSRF Prevention Cheat Sheet - separação por caso de uso e a diferença entre allowlist de aplicação e de rede.
- CWE-918 - Server-Side Request Forgery (SSRF) - o identificador para citar em relatório.
- PortSwigger Web Security Academy - SSRF - laboratórios gratuitos, incluindo os bypasses de blocklist e o caso cego.
- Orange Tsai - A New Era of SSRF: Exploiting URL Parsers - Black Hat USA 2017, a referência sobre divergência entre parsers.
- AWS - Use IMDSv2 - fluxo de token por
PUT,HttpTokens: requirede o efeito do hop limit. - GCP - Metadata server - exigência do cabeçalho
Metadata-Flavor: Google. - Azure - Instance Metadata Service - exigência do cabeçalho
Metadata: true. - Capital One - análise do incidente de 2019 - o caso público de SSRF encadeado com metadata e S3.
- RFC 3986 - Uniform Resource Identifier: Generic Syntax e WHATWG URL Standard - as duas especificações que explicam por que dois parsers discordam.